
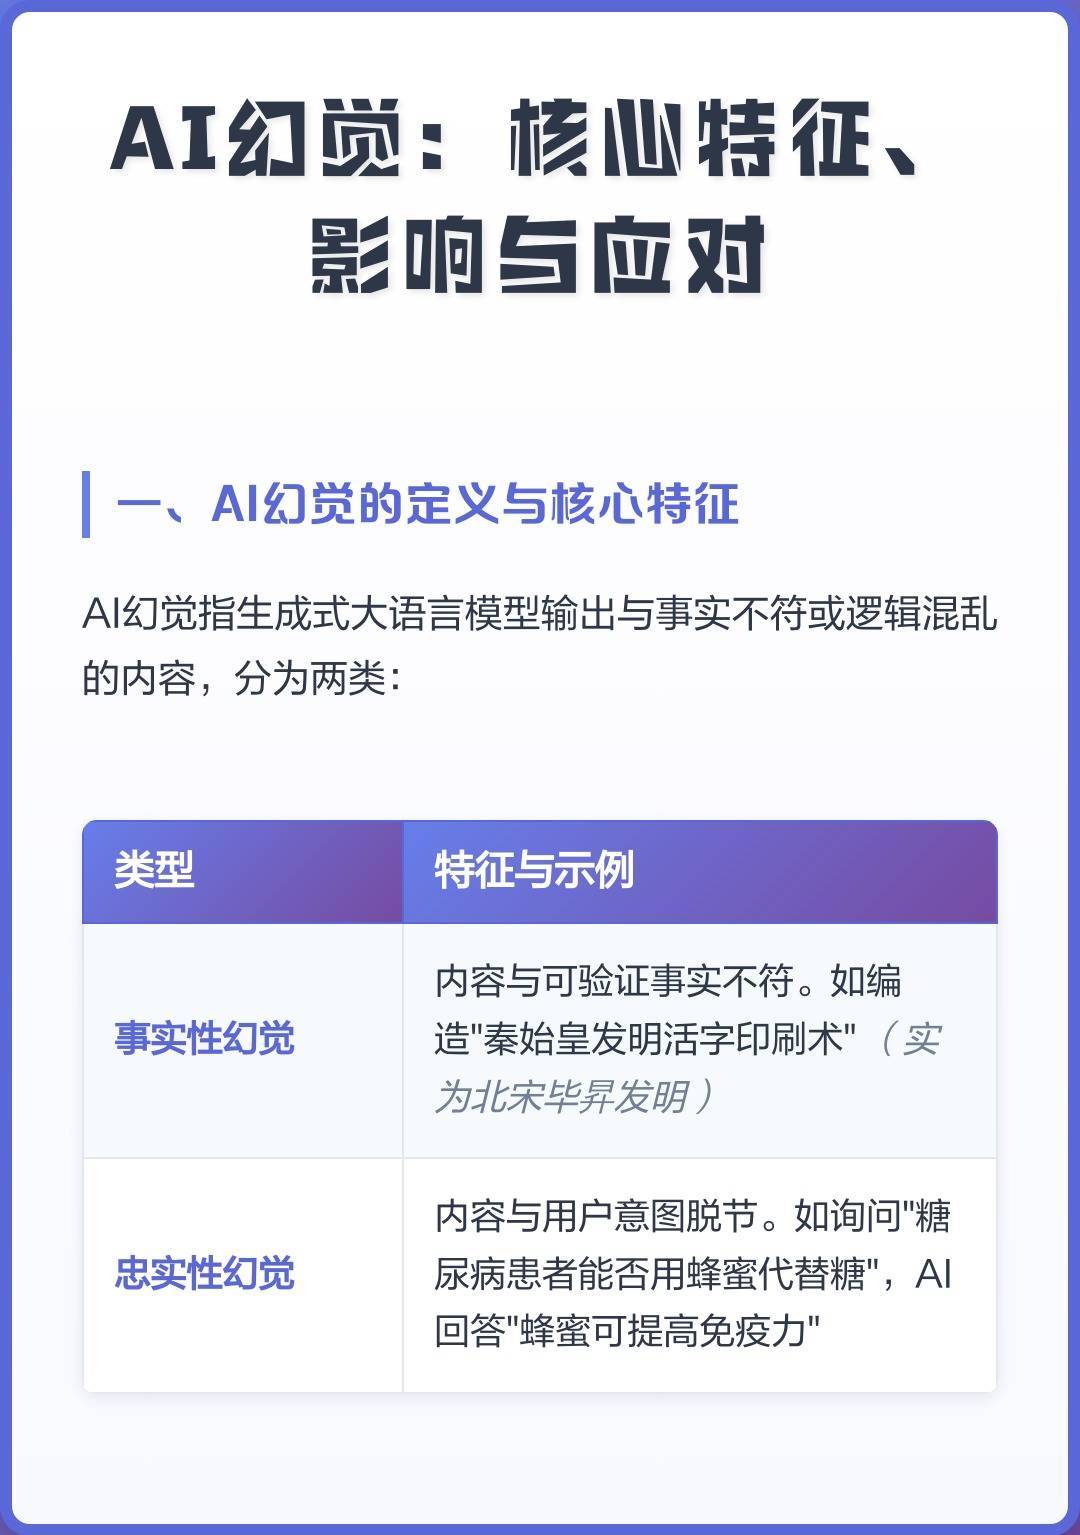
你有没有试过:同一份PDF里找一句话,第一次问AI,它秒回原文;第二次换种说法再问,它愣是翻遍全文也找不到——不是瞎,是真‘看不见’。字节跳动Seed团队9月底发在arXiv上的论文,终于把这口锅从AI头上摘下来了:问题不在模型‘笨’,而在它记东西的方式里,藏着一个叫‘相位盲区’的隐形陷阱。
简单说,大模型看长文档时,内存扛不住,工程师就给它“打包记笔记”:不是每个字都存,而是每256个字压成一条缓存。可这一压,就多出一个新坐标——这个字离‘打包起点’差几个位置?研究者管这叫‘相位’。结果发现:同样一段话,落在相位0~127时,AI检索准确率92%;挪到128~255,直接掉到53%。40个百分点的断崖,不是模型崩了,是它正巧站在自己的‘视力死角’里。
更实操的是,这个盲区其实能绕开。论文里提到,哪怕只在提问前加个句号、换行或空格,就可能让关键信息滑进下一个压缩块,瞬间‘重获光明’。用户不用懂算法,只要知道:AI不是总在装傻,有时候它只是站错了队。下次它又‘抽风’,别急着骂,试试删个逗号、加个回车——那不是玄学,是正在被破解的工程真相。
这事儿其实早有苗头。去年谷歌团队在测试Gemini长文本理解时,就发现同样的法律条文,放在段落开头和结尾,模型引用准确率能差出31%;Meta工程师在内部复现Llama-3的文档问答时,也观察到“位置偏移17个字符,召回率跌28%”的现象——只是当时没人把零散现象串成线。Seed团队这次用统一实验框架测了Qwen、Llama、Claude三个主流开源闭源模型,盲区位置虽有浮动,但“相位敏感性”在所有模型里都稳定存在。这不是某家公司的bug,而是当前主流压缩缓存机制绕不开的共性设计代价。
有人问:那直接取消分块不就完了?真不行。实测数据显示,若让模型全程保留原始token位置索引,单次长文档处理耗时增加3.2倍,显存占用翻4倍——手机端根本跑不动,连中等配置的笔记本都会卡死。工程师不是不想改,是得在“看得准”和“跑得动”之间踩钢丝。就像老式相机调焦,你得在清晰度和快门速度间做取舍。
有意思的是,普通用户反而比开发者更早摸到解法。小红书上有个叫“PDF提问玄学”的合集,收藏超12万,里面全是真实经验:有人发现把问题复制进记事本再粘贴回去,AI突然就懂了;有人习惯先敲三下空格再输入问题,准确率从61%升到89%;甚至还有人总结出“提问前必加emoji”的野路子——后来被证实,那个emoji恰好占了1个字节,让后续文本整体右移,刚好跨过了相位临界点。
技术圈现在管这叫“人类提示工程学”。它不教你怎么写prompt,而是教你读懂AI的呼吸节奏:什么时候该推它一把,什么时候该等它换气。这不是降维妥协,而是人机协作的新默契。就像我们早就习惯在打印机卡纸时轻轻拍两下——不是相信拍能修好机器,而是知道某些物理结构,就得用物理方式唤醒。
说到底,AI不是神,也不是宠物。它是工具,有脾气,有惯性,有藏在代码褶皱里的小倔强。我们骂它“智障”,不如说它正卡在人类为它设定的生存规则里。而真正的智能,从来不是单方面要求对方适应自己,而是双方一起,在限制里找到更舒服的姿势。
天顺优配提示:文章来自网络,不代表本站观点。